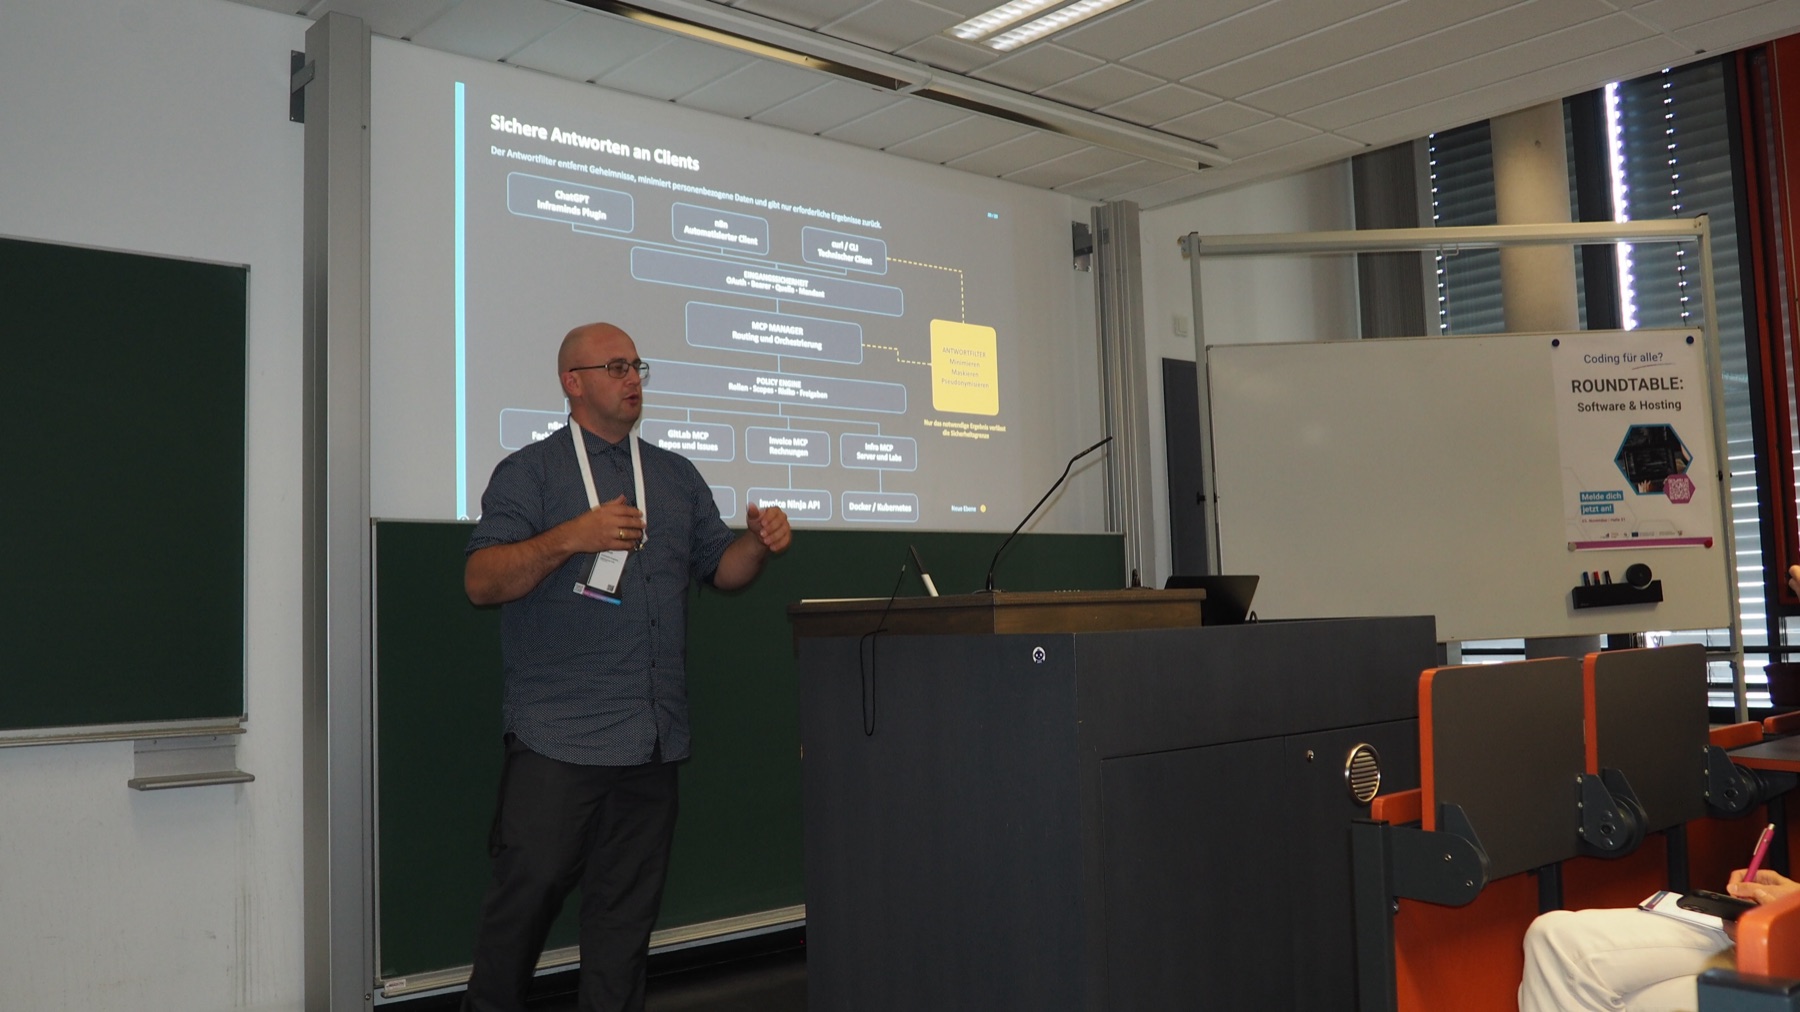
Auf der DigitalXchange 2026 ging es in meinem Vortrag um eine bewusst zugespitzte Idee: „Der Workflow ist kaputt. Der Workflow kümmert sich drum.“ Gemeint war kein System, das nach einem Fehler unkontrolliert an sich selbst herumschreibt. Die eigentliche Frage war: Wie kann Automatisierung Probleme erkennen, Änderungen sicher vorbereiten und anschließend beweisen, dass das gewünschte Ergebnis wieder erreicht wird?
Der Vortrag richtete sich an n8n-Anwender, Automation Engineers, technische Entscheider und Teams, die produktive Workflows betreiben. Die technischen Beispiele waren konkret. Die drei Grundgedanken gelten aber weit über n8n hinaus.
Ein Alarm ist noch keine Diagnose
Klassisches Monitoring meldet, dass etwas nicht funktioniert. Es übernimmt jedoch keine Verantwortung für den nächsten Schritt. Ein roter Status sagt weder, welche Ursache vorliegt, noch welche Änderung erlaubt ist.
Ein kontrollierter Reparaturprozess braucht Kontext: betroffener Workflow, Version, Fehlerort und Fehlerklasse. Ein stabiler Fingerprint hilft, wiederkehrende Vorfälle zu erkennen und nicht mehrfach parallel zu bearbeiten.
Dabei dürfen Rohdaten, Zugangsdaten und sensible Inhalte nicht unkontrolliert an ein Sprachmodell gegeben werden. Die Diagnose muss auf den nötigen, bereinigten Ausschnitt begrenzt sein.
Der Merksatz des ersten Teils lautete:
Ein Alarm weckt jemanden. Ein Fingerprint startet einen Prozess.
Eine Werkzeugwand statt eines Generalschlüssels
Ein KI-Agent wird nicht dadurch produktionsreif, dass er möglichst viele Berechtigungen erhält. Er braucht kleine, klar definierte Fähigkeiten.
Das im Vortrag gezeigte Modell trennt vier Ebenen:
- Lesen: Status, Struktur und bereinigte Fehlerinformationen erfassen.
- Planen: eine Änderung an eine konkrete Version und einen begrenzten Zeitraum binden.
- Schreiben: nur autorisierte und möglichst inaktive Komponenten verändern.
- Prüfen: Live-Verhalten und fachliches Ergebnis kontrollieren.
MCP diente im Beispiel als kontrollierte Werkzeugoberfläche. Entscheidend war nicht das Protokoll selbst, sondern die Designfrage: Welche minimale Fähigkeit darf das System unter welchen Bedingungen aufrufen?
Autonomie ist ein Budget
Zwischen „alles manuell“ und „der Agent darf alles“ liegen sinnvolle Stufen. Das vorgestellte Autonomiebudget begann beim reinen Beobachten, ging über Diagnose und Vorschlag bis zu einem Patch in einer sicheren Umgebung. Bei höherem Risiko oder überschrittenen Grenzen übernimmt ein Mensch.
Ein solches Budget umfasst nicht nur Geld. Es kann maximale Laufzeit, Anzahl der Versuche, veränderte Komponenten und das mögliche Schadensausmaß begrenzen.
Diese Regeln sind wirksamer als ständige Einzelbestätigungen. Wer jede Kleinigkeit freigeben muss, klickt irgendwann routiniert auf „Bestätigen“. Gute Leitplanken legen vorher fest, wann das System handeln darf und wann es zuverlässig stoppt.
Workflow zuerst, Agent nur bei echter Ungewissheit
Bekannte Fehlerklassen brauchen nicht immer ein frei entscheidendes Agentensystem. Ein fester Workflow ist oft sicherer und leichter zu prüfen. Ein Agent wird dort sinnvoll, wo Informationen eingeordnet, unterschiedliche Lösungswege bewertet oder Änderungen in mehreren Dateien koordiniert werden müssen.
Auch dann bleibt die Lieferkette Teil der Lösung: isolierte Änderung, Tests, Pipeline, begrenzte Auslieferung und Live-Prüfung. Eine automatische Reparatur ist nur so vertrauenswürdig wie der Weg, über den sie in Betrieb gelangt.
Keine Exception ist kein Geschäftsergebnis
Die wichtigste These des Vortrags war der Nachweis. Ein grüner Test beweist lokales Verhalten. Eine erfolgreiche Pipeline beweist ein reproduzierbares Artefakt. Ein Deployment beweist, dass ein bestimmter Stand läuft.
Erst eine fachliche Probe zeigt, ob der Unternehmensprozess wieder funktioniert. Wurde das richtige Dokument erzeugt? Ist die Information im vorgesehenen System angekommen? Wurde keine Nachricht doppelt versendet?
Die wertvollsten Erkenntnisse im zugrunde liegenden Projekt kamen aus falschem Erfolg: Ein technischer Teil meldete „erledigt“, während der Datenpfad an anderer Stelle weiterhin falsch war. Daraus folgt:
Der wichtigste Output ist nicht der Patch, sondern der überprüfbare Zustand danach.
Klein starten, vollständig prüfen
Der empfohlene Einstieg ist eine häufige, klar erkennbare Fehlerklasse. Zunächst liest das System nur und erstellt eine bereinigte Diagnose. Danach folgen Fingerprint, versionsgebundener Plan und ein sicherer Testlauf. Automatisches Schreiben kommt zuletzt.
Das zugrunde liegende Projekt entstand in einer konzentrierten Entwicklungsphase. Die Messwerte aus dem Vortrag – Commits, Tests und Codezeilen – waren ausdrücklich Projektwerte und keine Marktbenchmarks. Entscheidend war nicht ihre Größe, sondern die entstandene Betriebsstruktur: Ein Auftrag wird eindeutig übernommen, Änderungen bleiben einem Versuch zugeordnet und eine unabhängige Überwachung erkennt, ob die Arbeit noch läuft.
Auch die Wirtschaftlichkeitsrechnung im Vortrag war eine offene Szenariorechnung. Zeitaufwand, Stundensatz und Wirkungsrisiko wurden sichtbar gemacht, statt eine allgemeine Ersparnis zu behaupten. Genau so sollte ein Automatisierungsprojekt bewertet werden: mit Annahmen, die der jeweilige Betrieb nachvollziehen und verändern kann.
Das ist zugleich eine gute Vorgehensweise für Unternehmensautomatisierung allgemein: nicht sofort maximale Autonomie versprechen, sondern einen kleinen Ablauf vom Eingang bis zum nachweisbaren Ergebnis vollständig bauen.
Self-Healing war damit kein einzelner Vortrag über eine technische Spielerei. Es war ein Beispiel dafür, wie KI in verantwortbaren Systemen eingesetzt werden kann: mit begrenzten Fähigkeiten, klaren Stop-Regeln und einem Ergebnis, das sich außerhalb der KI überprüfen lässt.